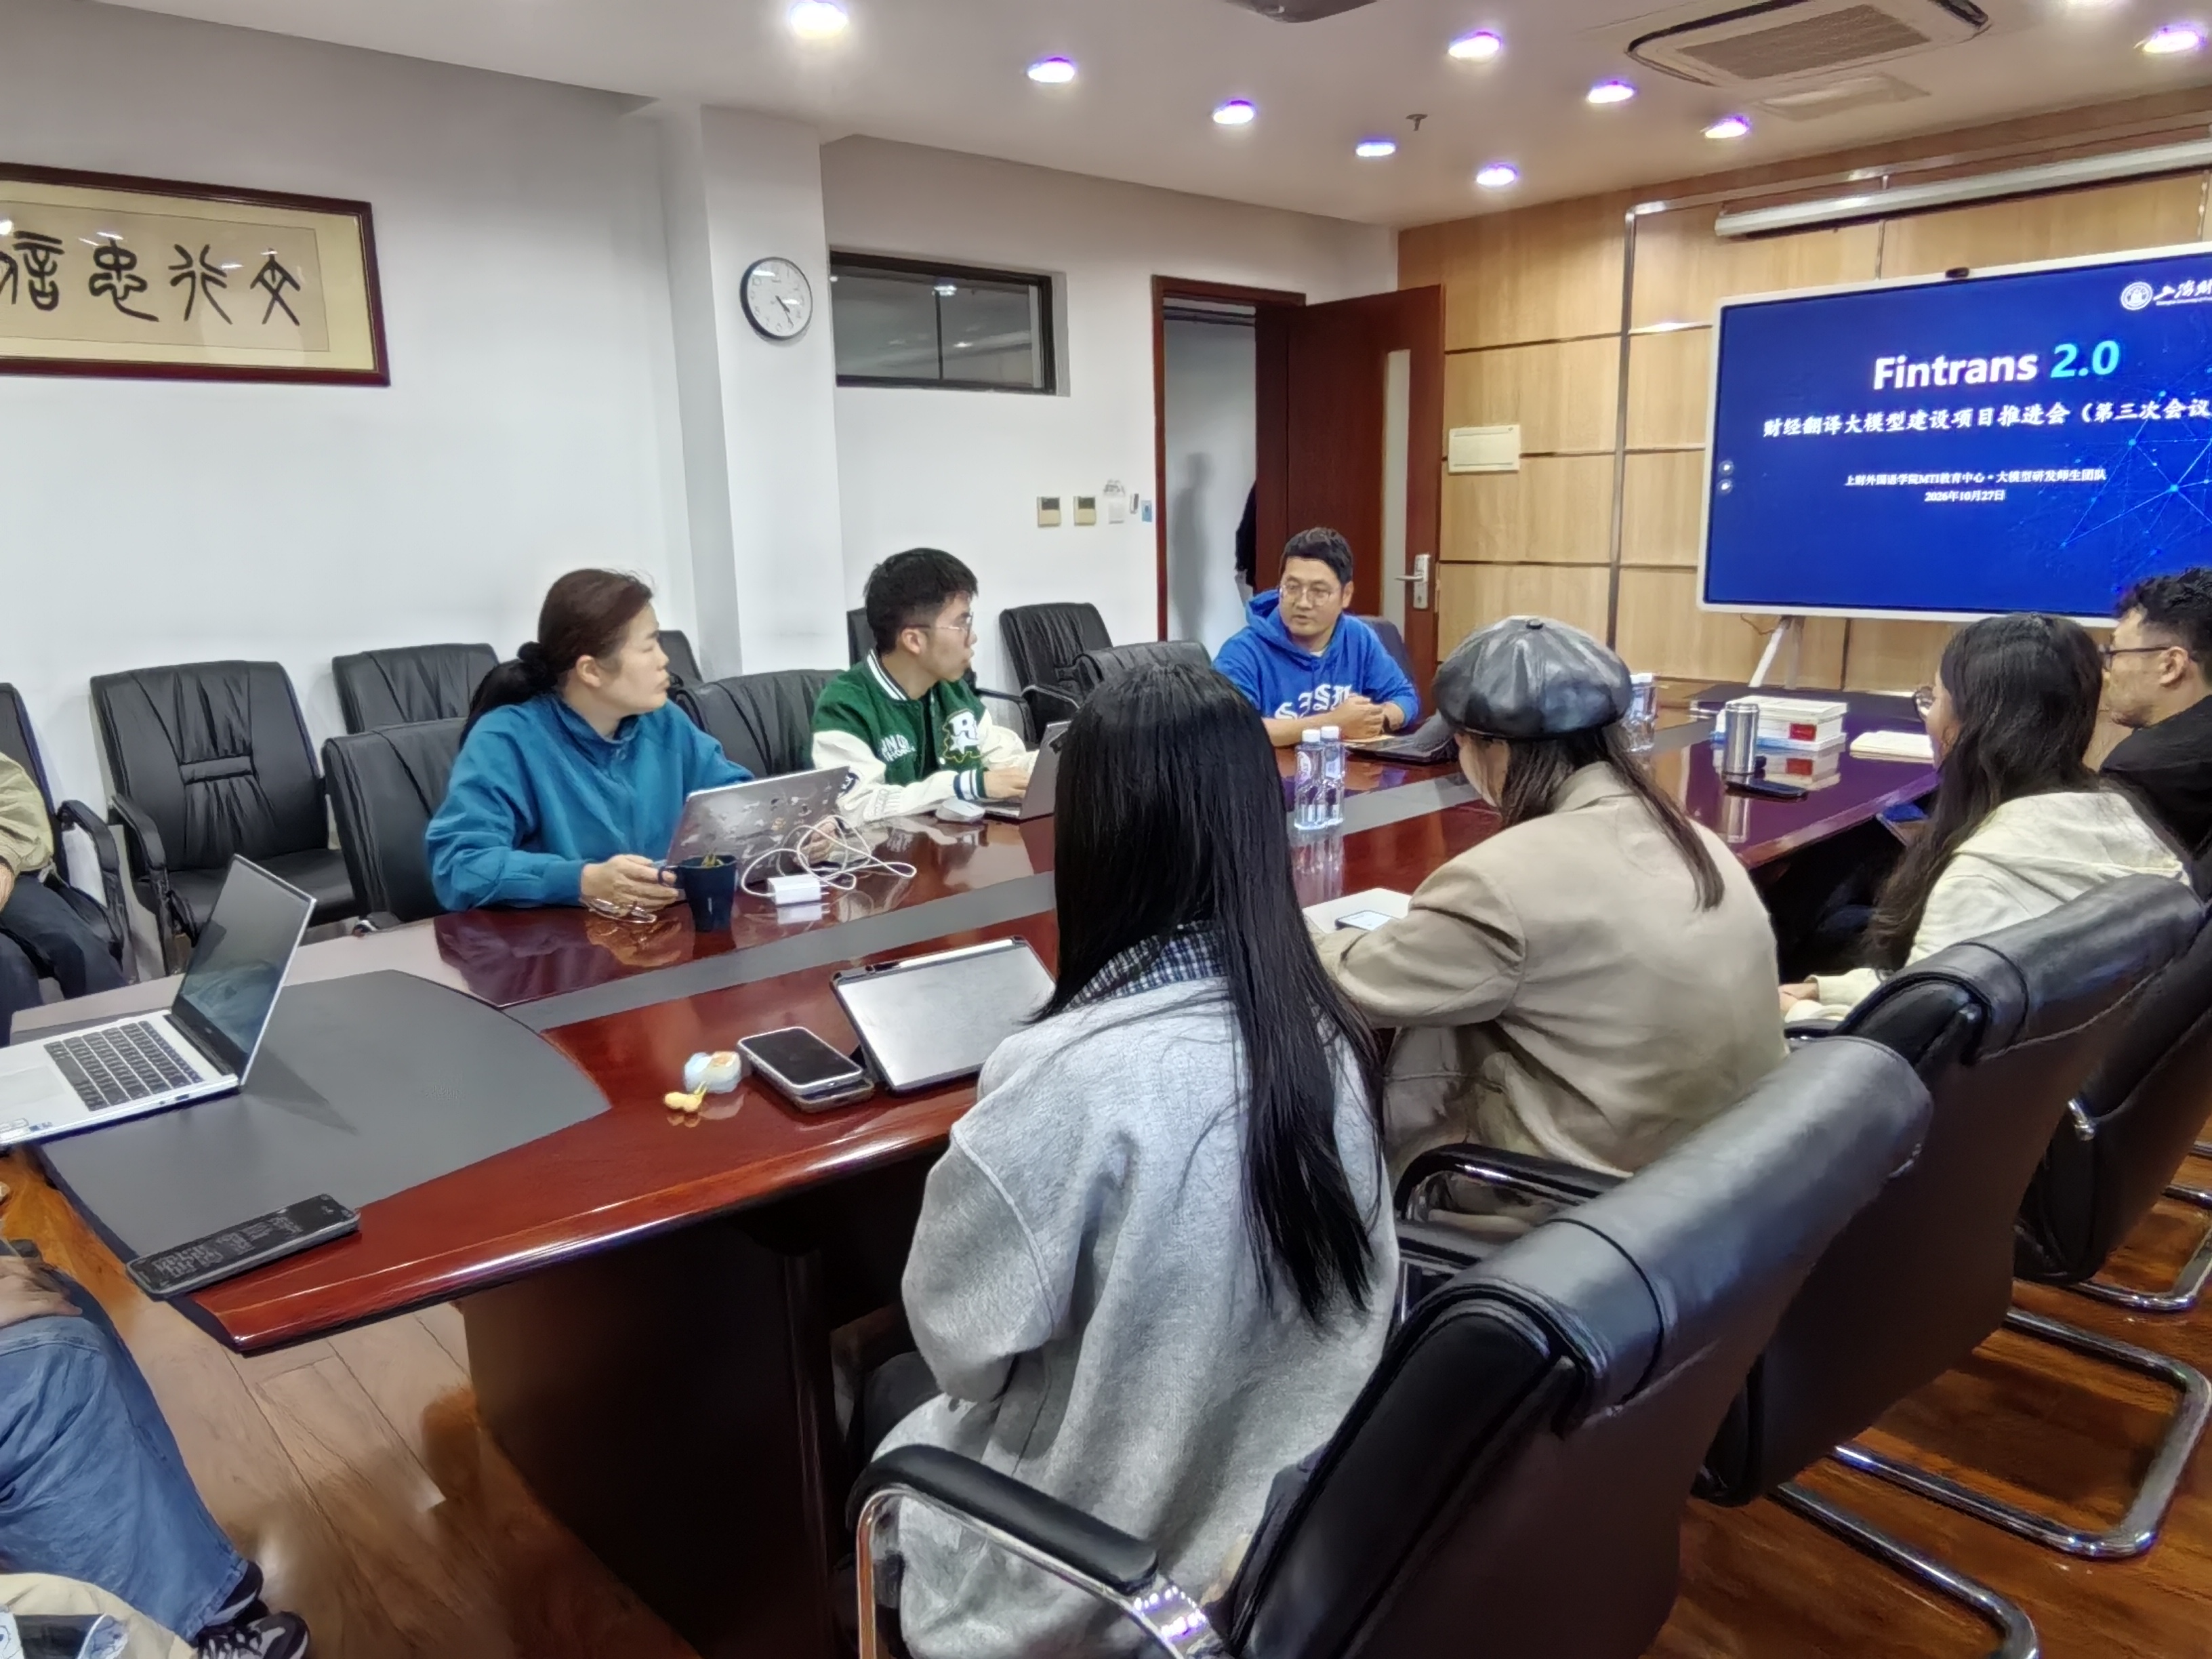
10月27日下午,上海财经大学外国语学院Fintrans2.0财经翻译大模型建设项目第三次推进会于红瓦楼426会议室举行。MTI教育中心郭鸿杰、潘贵生、王莉娜、穆欣等教师及项目组学生参会。会议复盘项目阶段性成效,聚焦语料处理技术瓶颈研讨对策,敲定下一阶段工作部署,重点围绕文本清洗、数据安全管控、文档对齐、质量核验等关键事项深入磋商,细化统一语料处理规范与任务准则。
会上,各工作小组依次汇报近期攻坚成果。第一组介绍目标数据采集进展,针对技术难点分享实操经验;第二组展示PDF转文本处理成果,直面OCR识别偏差、跨页断行、组内执行标准不一等痛点开展交流研讨;第三组汇报文档对齐工作推进情况;第四组完成涉外法律英文文本搜集与双语对齐工作。针对各组反馈的难点问题,与会教师逐一给出优化路径,提出要畅通组内、组间沟通渠道,汇总共性问题,统一操作范式,严守语料质量关口。
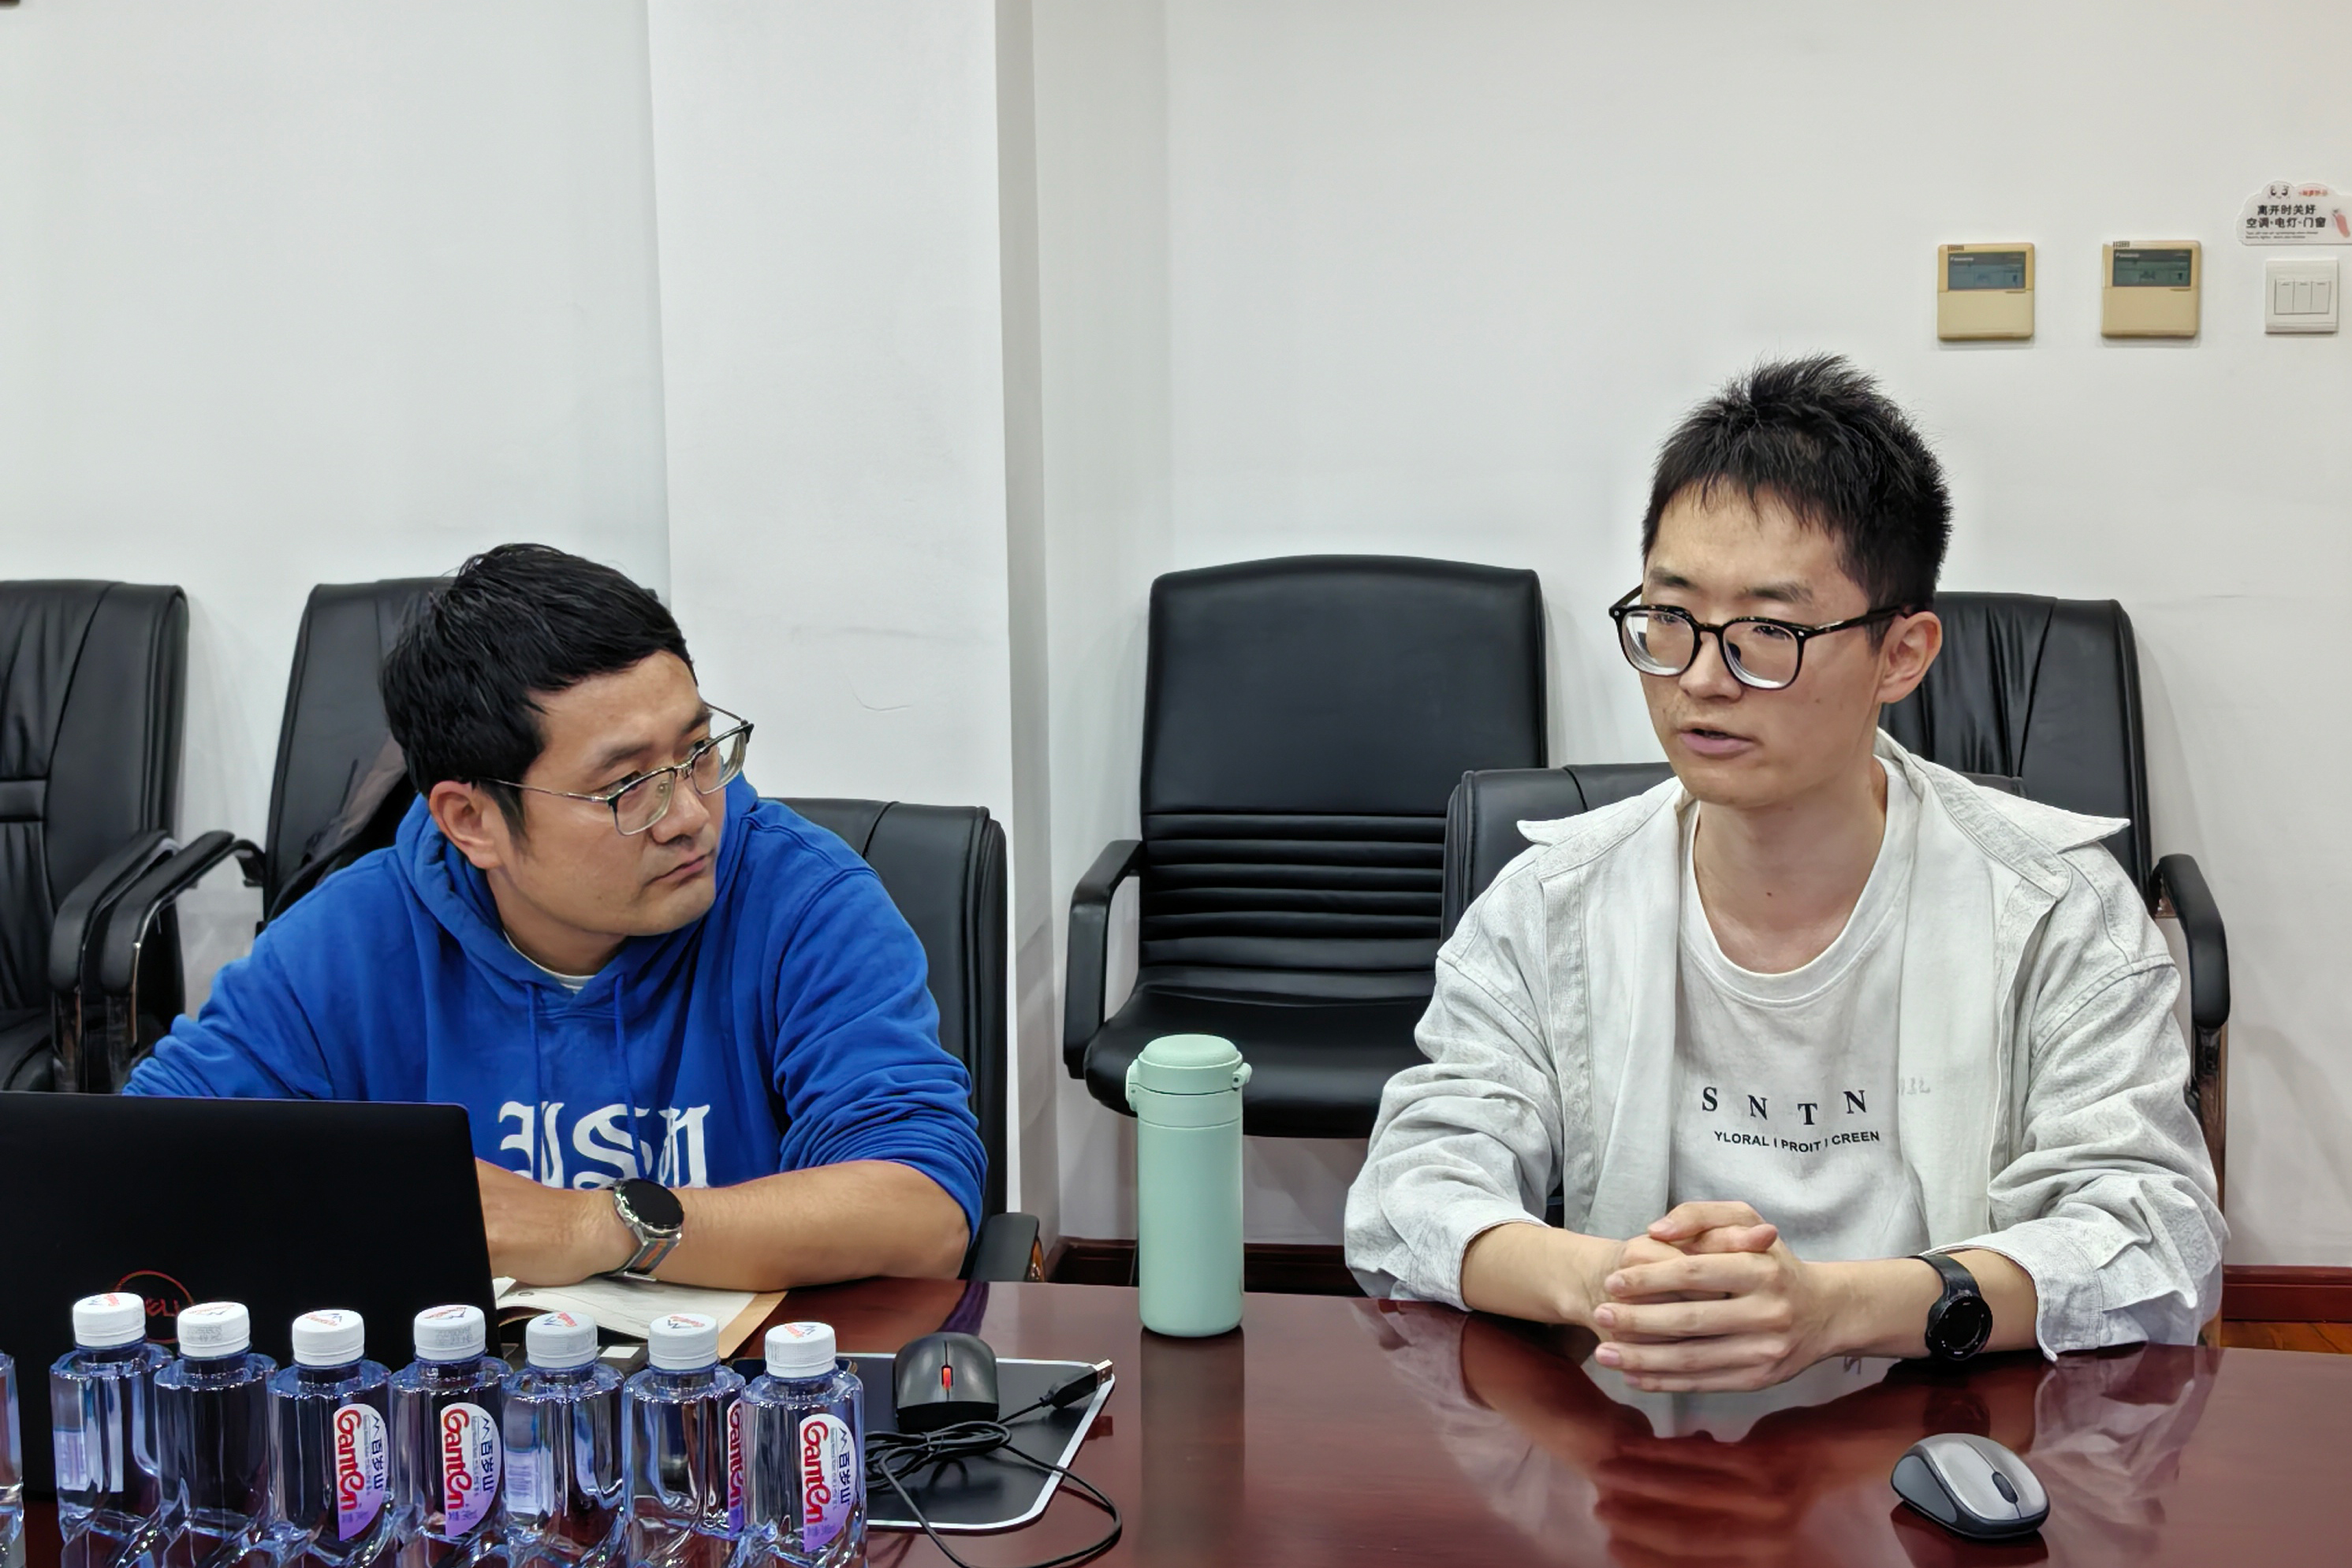
在技术指导环节,大模型首席建构师潘贵生老师对下一阶段语料处理技术规范与数据安全工作提出刚性要求。他指出,项目建设当以打造高质量语料底座为核心目标,细致讲解数据采集、文本清洗、双语对齐、人工校对各环节技术细则。他重申数据安全底线:核心任务处理严禁使用未获授权的云端工具、在线API处理重要语料,须依托本地化部署方案开展作业,筑牢语料数据资产安全防线。
郭鸿杰老师着重引导大家树立科研转化意识。他谈到,语料库建设不单是技术实操,更是淬炼科研素养、锤炼逻辑思维的一方试验田。同学们不可局限于流程化的基础操作,应当涵养问题意识,归纳语料加工中的各类错误范式,把碎片化实操经验提炼升维,形成体系化的学术思考。他勉励全体成员立足项目实践挖掘真问题,在导师团队指导下深耕细研,推动实操经验向学术成果转化迭代。
穆欣老师围绕自动化工具落地应用给出指导意见,建议同学们依托本地Python脚本,结合智能体交互迭代优化代码,破解数据采集、断行归并等重复性难题,以技术赋能提质增效。
会议同步明确下一阶段重点任务:项目组将以纸质文本数字化处理为试点,各组协同打通扫描录入、OCR识别、文本清洗、中英对齐全链条作业流程,在实操中熟悉语料建设全链路,固化统一标准,为后续大规模语料加工积蓄经验。
积跬步以成渊,聚微文而成章。本次推进会清晰盘点了Fintrans2.0财经翻译大模型建设阶段性成果,压实语料处理技术标准、数据安全责任与阶段任务,为项目稳步向前夯实根基。后续,项目组将恪守质量为先、依规作业、协同共进的原则,稳步搭建高品质财经翻译语料库;引导学生在实干中沉淀思考、精进科研能力,促成财经翻译实践与学术研究双向赋能、互促共进。
(供稿:王莉娜、郭浩铖(学) 供图:吴若言、周欣悦(学) 审核:郭鸿杰、潘贵生 编辑:夏润)